AlphaZeroでコドゲの過去問を解いたので備忘録
AlphaZeroベースのボットでCodinGameの過去問を解き、全体7位ほどになったので備忘録を書き残しておこうと思います。
NNフレームワーク
NNフレームワークは自作のものを使用した。PyTorchやTensorFlowなどは現時点のコドゲでは使えなさそう。せめて訓練だけにはPyTorchを使いたいというのであれば、この記事に、PyTorchで訓練したモデルをNumPyで再実装し、C++の埋め込みをコンパイルしてAtCoder上で走らせたという話が書いてあるので真似ればある程度はいけそう。コドゲでC++を埋め込めるかは不明。ただ、全体的に複雑なので自作のライブラリを使うのでもそこまで悪くないと感じた。しかし、AlphaZero同士の対戦になるとモデルの速度と精度で勝負が決まるので、簡単なMLPしかサポートしていない自作ライブラリを使うのは少し躊躇われる気もした。
NN
AlphaZeroでは探索回数も性能に影響してくるので、結局はモデルの大きさと性能の良さの比率がかなり重要になってくる。そう考えるとNNのキャパシティを無駄にしてしまうAuxiliary labelなどは使用するべきではないと感じた。訓練の序盤だけ使用して、後半は重みを0にするというのもあるのかもしれないが、モデルが小さく課題も簡単なことが多いため、そんなに重要ではないと思った。
モデルが小さいのでパラメーターを埋め込んでもそこそこの大きさにしかならないので、提出時のコード長の心配はそこまで必要がないと思った。
AlphaZero
オセロAIの記事にも書いたとおり、基本的にはこの論文を元に実装しておけば問題ないと思った。ただし、まだ探索していない子ノードの評価値をどうかするのかは未だによくわからない。論文ではValueを0に設定してあるが、少し不安が残るので今回は親ノードと同じ値を使用するようにした。
コドゲで使用するくらいの大きさのNNであればすぐに性能がサチるので、長く自己学習を回す必要性は感じなかった。また、訓練データもそこまで拘る必要がないと思った。過去のランダムな対戦レコードを使い回せば事足りるように感じた。結局モデルや挙動はどれも似たようなものだからか。よくわからない。
実際にイテレーションを回している時に面倒だと感じたのはモデルの訓練だった。特徴量を変えるたびに訓練を回してから対戦を回し始める必要があったので、単スレッドのNN訓練を待つのが面倒だった。
Policyの訓練に使うターゲットは実際に選ばれたアクションではなく、MCTSの探索比率を使うといいとどこかで読んだ気がしたので、そうした。結局どちらのほうが良かったのかはわからない。
シミュレーター
過去記事に従ってシミュレーターをセットアップした後に、本家シミュレーターのコードを再利用しつつ自分でシミュレーターを書くのがいいと思った。NNモデルの訓練には自作のシミュレーターのログを使う。ログするのはボットに渡した入力をそのままログしておくとコードを再利用しやすくてよい。特徴量をログするのではなく訓練時に生インプットから逐一生成するのが安全。
自作シミュレーターの方が本家シミュレーターよりも速度は速くなる。ただ、ボットとの通信に時間がかかるせいか、どちらにせよ多少のオーバーヘッドがあるように感じた。
速度を気にするならC++でシミュレーターを書いて、ソルバーのコードをそのままfunction callできると良さそうに感じるが、そうするとソルバーのグローバルに変数を置きづらくなったり、諸々の初期化がバグってしまうかもしれないので、素直に本家のシミュレーターを再利用してソルバーはソルバーのままにしておくのがよいと思った。
ソースコード
訓練用のコードの大部分はソルバーのコードをそのまま利用できるので、実装はすごく簡単になる。ある程度慣れればAlphaZeroはかなり手軽に試せる手法なのかもしれない。
その他
実際のところ、AlphaZero最強というわけではなさそうに感じた。手動で精度のいい高速な評価関数が作れるのであれば事足りる。今回音コンペはかなり正確に確率を計算できたのでそこまで性能が出なかった気がした。また、ゲームにターン毎のランダム要素があるのもAlphaZeroを使いづらくした気がする。
数学検定1級 合格!
こんにちは、七枝です。
2024年4月に実施された数学検定1級に合格することができたので、その際の勉強方法や試験に関することなどを書き残しておこうと思います。
動機
『数学ゴールデン』という数学オリンピックに挑戦する漫画を読み、自分も久々に数学をしたくなり数学検定に申し込みました。普段そこまで数学に触れてはいませんが、仕事で統計や機械学習周りの数式に触れる事もあるので多少は覚えているかなといった状況でした。
勉強 【残り3ヶ月半】
試験対策における定石として、何年分かの過去問を最初に解いておいて感覚を掴んでから勉強を始めるというものがあります。しかし、純粋な実力のみで合格した方がテンションが上がるので、過去問は本家ウェブサイトに掲載されている1回分を軽く流し見するだけに留めました。
勉強方法としては、試験範囲をおおよそカバーするであろう教材を揃え、それを解き続けていました。以下が、その時に使った教材となります。
- 『チャート式シリーズ 大学教養 微分積分』
- 『チャート式シリーズ 大学教養 線形代数』
- 『統計検定準1級対応 統計学実践ワークブック』
- 『Complex Analysis』 by Edinburgh大学
- 『微分方程式の解法一覧』 by Ushitora Lab 様
どの分野に注力して如何に勉強した、といったようなものは特になく上記の教材に載っている問題を全て等しく解けるようにしていました。ただ、留数定理だけはあまりにカッコいいので絶対に解けるように練習していたのですが、数検ではあまり出題されないと後に知り愕然としました。
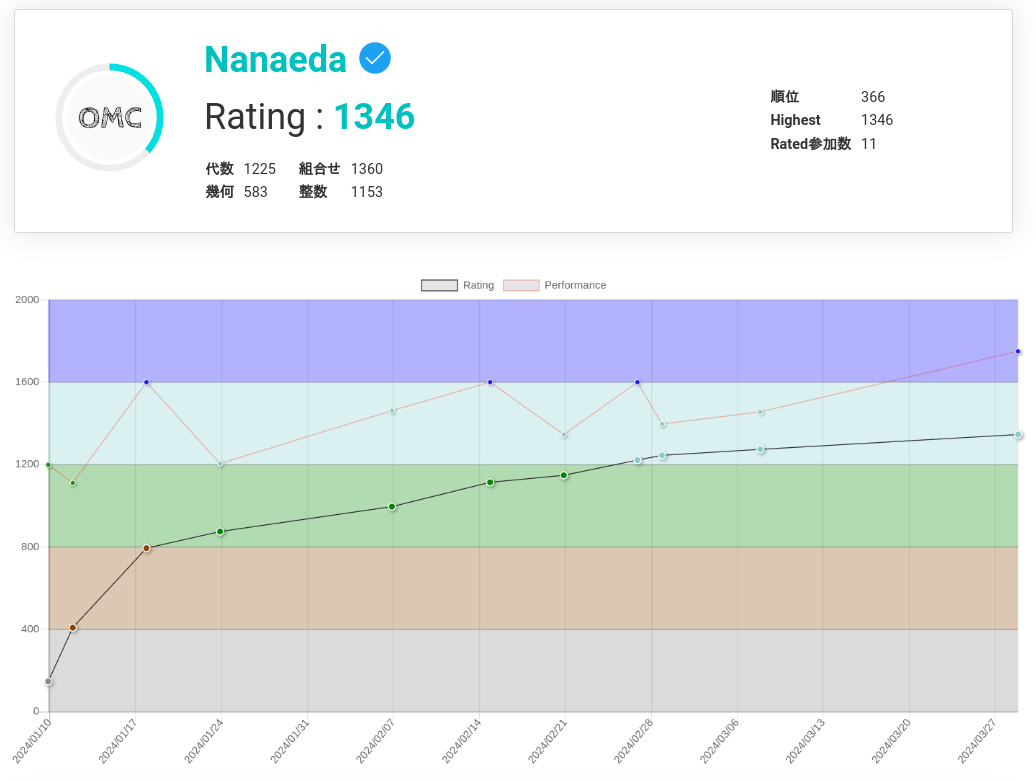
また、上記の教材とは別に Online Math Contest (OMC) という数学コンテストに参加していました。高校数学は遥か忘却の彼方、整数問題などはどうやって勉強すればいいのかわからない、そんな状況にあった私にとっては非常に大きな助けとなりました。あと普通に楽しかったです。
勉強 【残り2ヶ月】
試験勉強における失敗の1つとして、勉強を早く始めすぎるというものがあります。この頃になると自分も余裕を感じ始め、過去問も解かずに純粋数学の勉強をしていました。ガロア理論難しかったです。
勉強 【残り1ヶ月】
そろそろ試験の日も近いということで数検の勉強に復帰しました。上記の教材を何度か解き直した後に、ようやく過去問に取りかかりました。
驚くほど難しかったです。こんなに解けないものなのかと。出題される問題の傾向が少し思っていたのと違ったというのもありますが、覚えた公式や解き方を直接適用するだけでは解けないような問題が想定よりも多くて焦りました。とは言え結局のところ、過去問や演習問題を解く以外にできることもなさそうだったので、問題を繰り返し解き続けていました。
お世話になった教材達:
試験当日
試験直前に勉強しすぎると、勉強したことがノイズになり、逆に実力を発揮できないことが多いです。なので、当日の朝は過去問で一度も見たことがない、教材の隅の方に書いてある問題をのんびりと解いていました。
遅刻しないか不安なので2時間ほど前に会場につきました。試験直前にならないと建物に入ることができないので、外で延々と微分方程式を解き続けていました。 (今更ですが微分方程式は覚える以外に解く方法があるのでしょうか)
一次試験
パニクりました、1問目から。後の検算も入れると4通りもの答えが出てしまいました。段々と計算に対する自信を失っていったため、0.5点×2の問題は飛ばしてしまいました。片方の計算をミスって0.5点だけ取ってしまうことを恐れました。
そんなこんなで、最後の微分方程式に辿り着く頃には頭が真っ白になっていました。そのため焦りからか、試験前に解いた形だと誤認して式変形を進めてしまいました。試験直前に勉強するとこういうことになるので本当に良くないです。しかし、結果として何故か別の知ってる形に変形されたので解くことができました。微分方程式は検算が楽なので解けると安心です。
そうこうしているうちに一次試験は終わりました。7問中6問解いて、解いた問題にはわりと自信がある状態でした。
二次試験
選択問題を見ると雑念が生まれるので、選択問題は見ずに必須問題から取りかかりました。過去問で一度も見たことがない、教材の隅の方に書かれているような問題が出題されました。そうです、当日の朝に触っていた問題です。大ラッキーでした。しかし、朝解いたことが逆にプレッシャーとなり緊張してしまった結果、その問題だけで1時間以上も使ってしまいました。もうダメです。大アンラッキーです。解けない方がまだマシでした。試験日は勉強しないほうがいいです。もう一つの必須問題は工夫すれば簡単に計算できるタイプの微積分だったので手早く終わらせました。
選択問題は決め打ちで統計の問題を選びました。統計に自信があったので解けると思い込んでいましたが、小問2はかなり怪しかったです。選択問題は問題をちゃんと読んでから選んだほうがいいです。最後の1問は整数問題を選び、部分点を取りに行こうと思ったのですが、偶然にも完答することができました。
手応えとしては、最良で4完、おそらく3完半弱だと思っていました。
結果と感想
結果は以下の通りでした。
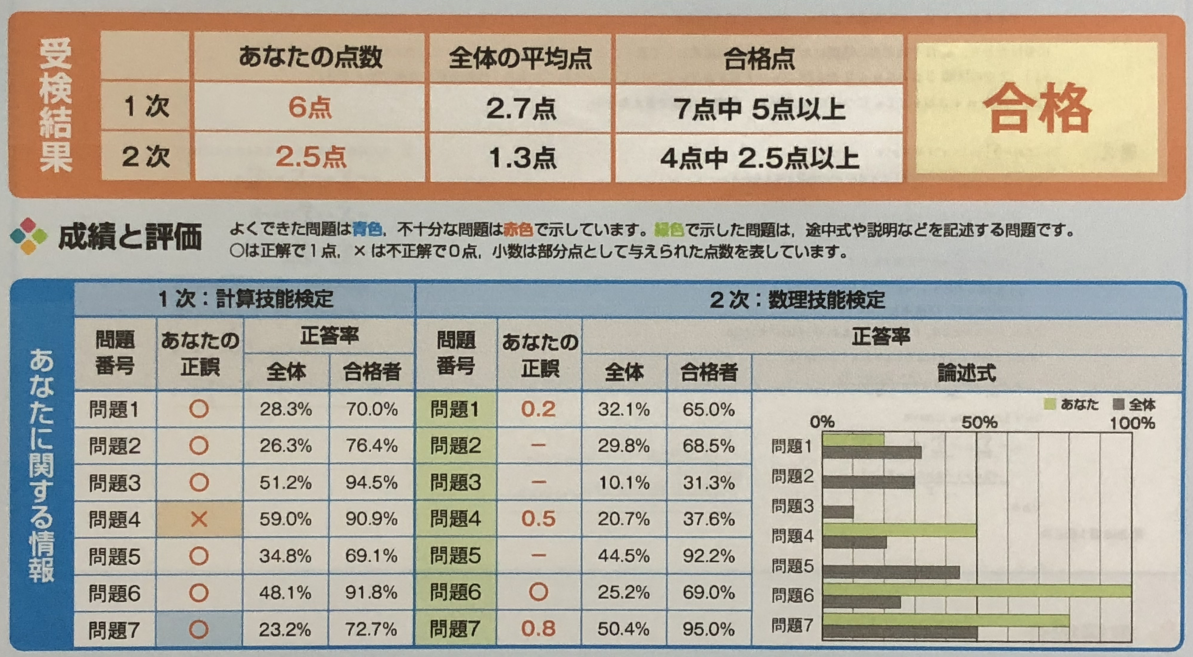
まさかの二次が2.5点で合格点ちょうどでした。点数を見るその瞬間まで、4完すらもありうると本気で信じていたのですが一体何が起こったのでしょうか...
何はともあれ、ギリギリではありましたが結果だけ見れば1発合格ということになりました。運転免許証を失効してしまった今となっては、私の持っている唯一の資格です。お亡くなりになった運転免許証と並べて神棚に飾っておこうと思います。
CodinGame Spring Challenge 2024の3位解法
先日CodinGameで開催されたSpring Challenge 2024において3位を取ることができたので、その時に使った解法などを書き残しておこうと思います。本記事はCodinGameのフォーラムに投稿したものの日本語版となります。フォーラムに投稿したものは文章の長さなど気にして削除してしまった部分もあるので、本記事の方が少しだけ長めになっています。
概要
今回はDUCTを使用しました。何らかの考えがあってDUCTを選択したというよりは、単純に多人数同時プレイ用の手法をよく知らなかったというのが理由です。木の探索方式などはAlphaZeroの論文に書かれていたものをほぼそのまま採用しましたが、ノードの評価等には手で実装したヒューリスティックを使用しました。最終的にはAlphaZero (= 強化学習ベースのNN) へ移行できればと思っていましたが、実装や時間の厳しさから最後までNNへの移行は行われませんでした。
詳細
- 全体の流れとしては、まず各ターンの初めに根のみからなる木を生成します。そこから探索を繰り返すのですが、各探索では根からノード選択アルゴリズムに従い葉まで移動します。その後、その葉におけるゲームの盤面を評価し、その葉の下に子を追加してから逆伝搬を行います。子の追加時には各ミニゲームをシミュレートし、必要があれば新たなゲームも開始します。ただし、スケートに関しては、初めのアクション以降のシミュレーションはスキップし盤面を凍結していました。
- 各ノードの評価には最終的なゲームの勝敗確率、つまり順位表のレーティングの増減値を使用しました。詳細は下の方で再度書きますが、ゲームの勝敗確率の計算には以下の要素を用いました。
- ということで、『現行のミニゲームにおける獲得メダルの予測分布』、例えば『現行のハードルに対して、プレイヤー1は50/30/20%の確率で金/銀/銅メダルをとる』といったものを予測する必要があります。
- 例えば、アーチェリーについては、『今からNターン後にいる場所の分布』といったものを計算していました。『1ターン後に、プレイヤー2は50/10/10/30%の確率で場所(1, 3)/(7, 3)/(4, 6)/(4, 0)にいる』といった具合です。また、Nターン後の場所分布はN-1ターン後の場所分布を利用して計算していました。これらの計算を繰り返すことにより、各プレイヤーの最終ターンにおける場所分布が得られるので、それらを比べることにより獲得メダルの分布を計算していました。
- 他のゲームについても、Nターン後のゲームのステートなどを計算することで獲得メダルの分布を予測していました。
- 場所分布などを計算をする際には、現行のミニゲーム終了時まで常に、各プレイヤーがrandom / reasonable / seriousのいずれかのモードにいると仮定しました。例えば、randomモードにいるプレイヤーは上下左右一様に確率25%で移動し続けます。また、seriousモードにいるプレイヤーは最適な動きをし続けます。これらの各モードに関して最終的な場所分布を計算した後に、それらの加重平均をとることで各プレイヤーの場所分布としました。
- コンペの序盤では、最終的な場所分布だけでなく各ターン毎に加重平均をとっていました。しかし、それだと、ダイビングで相手が10回以上のコンボを決めてくることなどを予期できず、自分のコンボを早く打ち切りすぎてしまうといった事態が発生しました。そういった理由から、現行のミニゲーム中は常にいずれかのモードにいるという仮定を置きました。
- Policyの計算はノード評価時に使った値などを再利用した凄くシンプルなものでした。正直あまり性能はよくなかったと思います。NNに移行したかったです。
ノード評価に関しての深掘り
- 前述の通り、最終的なゲームの勝敗確率を用いてノードの評価をしているわけですが、この計算がかなり重いです。なので、探索回数を稼ぐためにはこの部分の高速化が必須でした。
- 最終的なゲームの勝敗確率は以下の手順で求めることとしました。
- 上記のプロセスの中で、4つのミニゲームのスコアを掛け合わせた値の分布を計算する部分が一番重いです。例えば、各ゲームの得点が0~30点までの範囲に収まると仮定すると、31^4通りのスコアの組み合わせが存在するので、素直に計算するのはかなり厳しいです。なので、この部分を高速化する必要がありました。
- 高速化のため、logを取ってから多項式の掛け算をすることでそれを求めることにしました。例えば2つのミニゲームのスコアを掛け合わせた値の分布を求める場合、次の様な手順を取ります。
- 元のスコアの分布: {2点: 30%, 8点: 20%, 16点: 50%}, {2点: 40%, 4点: 60%}
- Binary log: {1: 30%, 3: 20%, 4: 50%}, {1: 40%, 2: 60%}
- 多項式化: {0.3 * x^1 + 0.2 * x^2 + 0.5 * x^4}, {0.4 * x^1 + 0.6 * x^2}
- 掛け合わせる: {0.12 * x^2 + 0.26 * x^3 + 0.12 * x^4 + 0.2 * x^5 + 0.3 * x^6}
- 元の表現に戻す: {4点: 12%, 8点: 26%, 16点: 12%, 32点: 20%, 64点: 30%}
- 実際には、少し精度は落ちてしまいますが、高速に多項式の掛け算をするために、得点のlogを取ったものをスケールした後に整数化をしました。そうすることでFFTやKaratsubaなどの手法が使えることになります。ただし、実際に実験してみたところ、SIMDを利用したナイーブなアルゴリズムが最速でした。理由としては、多項式の次数を小さめに抑えていたことや、スコアの分布がスパース (0が多い) なことなどが挙げられると思います。
- 高速化のため、logを取ってから多項式の掛け算をすることでそれを求めることにしました。例えば2つのミニゲームのスコアを掛け合わせた値の分布を求める場合、次の様な手順を取ります。
- 全体の探索回数としては大体3000+回程度でした (遅いマシーンにあたった場合は1000+回程度でした)
ChatGPT自作入門
本記事は、そこそこ自力で ChatGPTを自作するための解説&実装例となっています。ただ、現時点では ChatGPTの詳細は明かされていないようなので (2023-06-01)、実際には姉妹モデルである InstructGPTモデルを実装していくことになります。また、 InstructGPTモデルを作成するには、複数のモデルを訓練する必要があり、多量の計算資源や手動でのラベル付けが必要となります。なので、高性能なモデルを訓練するのは少し難しいですが、少なくとも実装だけはすることができます。
間違いなどを見つけた場合は、優しく教えていただけると嬉しいです。
目次
ChatGPTの概要
ChatGPTの生みの親である OpenAIのホームページには、 ChatGPTがどのように作られたのか、ということが軽く書かれています。しかし、 ChatGPTが InstructGPTモデルの姉妹モデルであるという以上のことは書かれていません (2023-06-01)。この InstructGPTモデルは、質問に対して答えを生成する NNモデルです。作成方法はこちらの論文に書かれており、以下の手順を辿ることで作成されます。
(1) ベースとなる一般 GPTモデルを訓練する。
(2) 1のモデルをプロンプト応答用にチューニングする。
(3) 2のモデルを強化学習を使い、更にチューニングする。
ということで、ここからはこれらの工程を1つずつ辿っていくことになります。
ベースとなる一般 GPTモデルを訓練しよう
GPTモデルの概要とアーキテクチャ
GPTモデルは文章を渡された時に、次の文字を予測するモデルです。例えば、 吾輩はという文字列が渡された時に、 猫などと出力します。また、出力された 猫を付け加えた 吾輩は猫を次の入力としてモデルに渡すと、 でなどと出力します。このステップを繰り返すことにより、 吾輩は猫であるといった文章が生成されます。
では、そんな GPTモデルの NNアーキテクチャはどんな感じかというと、本記事で使用するものは以下のようになっています。
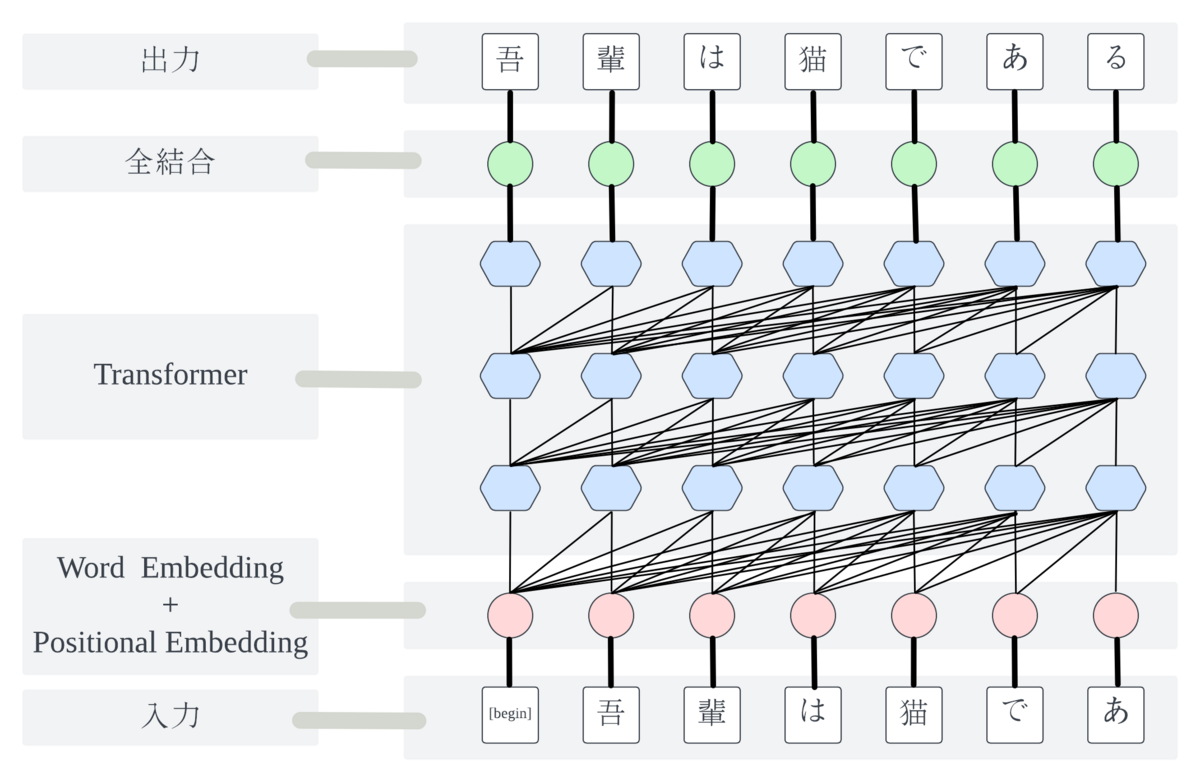
各コンポーネントについては、各々の実装時に詳細な説明をするので、ここではマクロ的な説明をします。 GPTモデルは受け取った文章の次の文字を予測するモデルです。しかし、上の図では、ほぼ全ての文字を受け取って、全ての文字を出力しています。少し不思議に感じますが、これは GPTモデルが実際に全ての文字を予測しているためです。 GPTモデルはアーキテクチャの構造的に、 i番目の文字を予測する時には i番目以降の情報が使われないようになっています。例えば、下の図のように、 猫を予測する時はそれよりも左下の情報しか使われていません。
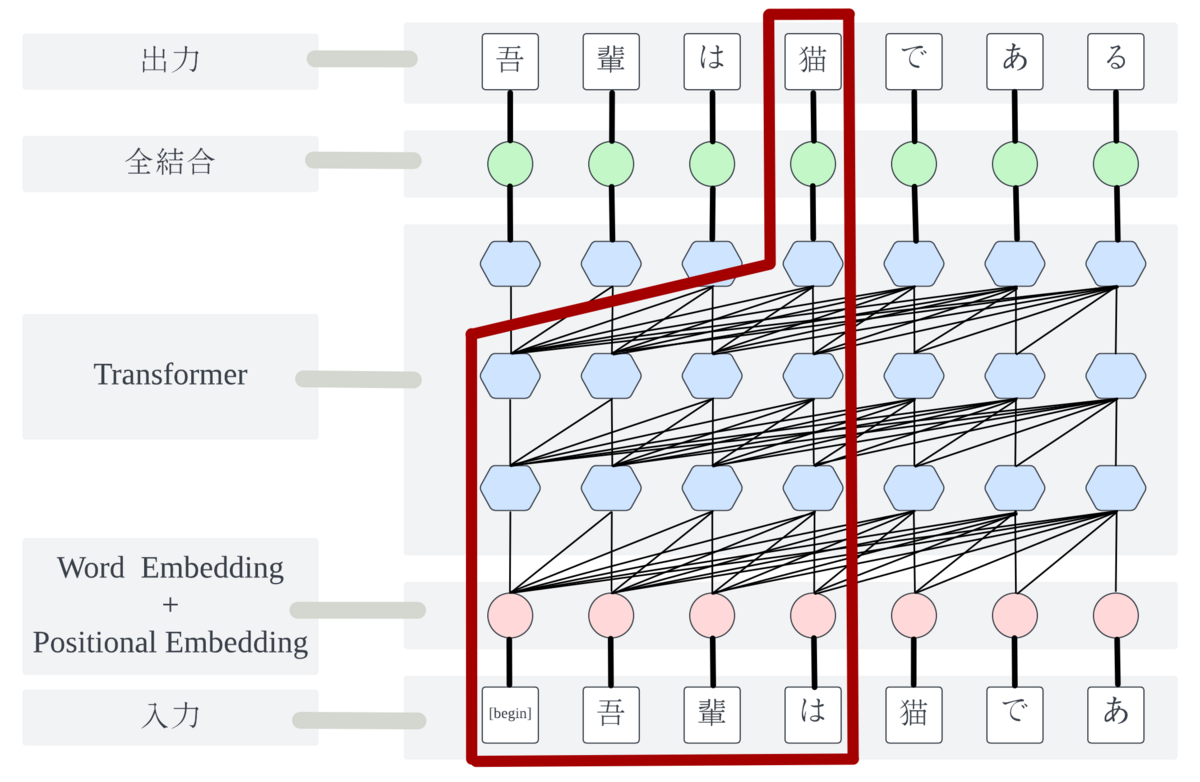
このように未来の文字の情報を受け取らないようにすることで、全ての文字を同時に予測することが可能になっています。
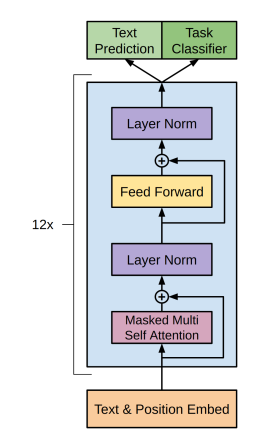
ちなみに GPTモデルの論文では、以下のような図がアーキテクチャとして書かれています。いくつかの違いを除けば (最終層、 Transformer層の数)、上の図と下の図のアーキテクチャはほぼ同じものとなっています。
データを用意する
GPTモデルは、文章の次の文字を予測するので、日本語の文章さえあれば訓練することができます。ということで、まずは日本語の文章を用意していこうと思います。今回は、こちらのAhmedさんのデータセットをお借りしようと思います。そこも自分で用意したいという方は Wikipediaのダンプなどから抽出してもいいのかもしれないです。
~ > head -n 5 wiki-sentences.txt
テネシー大学、デューク大学、フロリダ大学などからのオファーもある中、彼が選んだのはノートルダム大学であった。
9月5日、シカゴ・ベアーズとプラクティス・スクワッドとして契約を結んだ。
12月19日、クリス・コンテが故障者リスト入りするのと入れ違いにアクティブロースター入りした。
クロード・ドビュッシーの曲を原曲にした楽曲をリリースした。
又、のちに山口裕加里が同曲をカバーした。
データを読み込む
では、データを Pythonで読み込みます。ただ、 NNモデルで文字を直接扱うのは少し厳しいので、ここではシンプルに各文字を数字にマッピングしておこうと思います。つまり、 {吾 → 0, 輩 → 1, は →2, …}といった感じのマッピングを作成します。
GPT-2や GPT-3では、 {吾輩 → 0, は → 1, 猫 → 2, である → 3, …}のような、もう少し纏まったレベルでのマッピングを行います。ただ、初めにトークナイザーばかり作り込むのも何とも言えないので、本格的な実装は後に回そうと思います。
事前知識: PyTorch
本記事では、主に PyTorchを使います。ただ、 PyTorchの基礎的な機能しか使わないので、この公式チュートリアルがわかるくらいの知識があれば、問題ないと思います。
実装: 入力と出力だけ
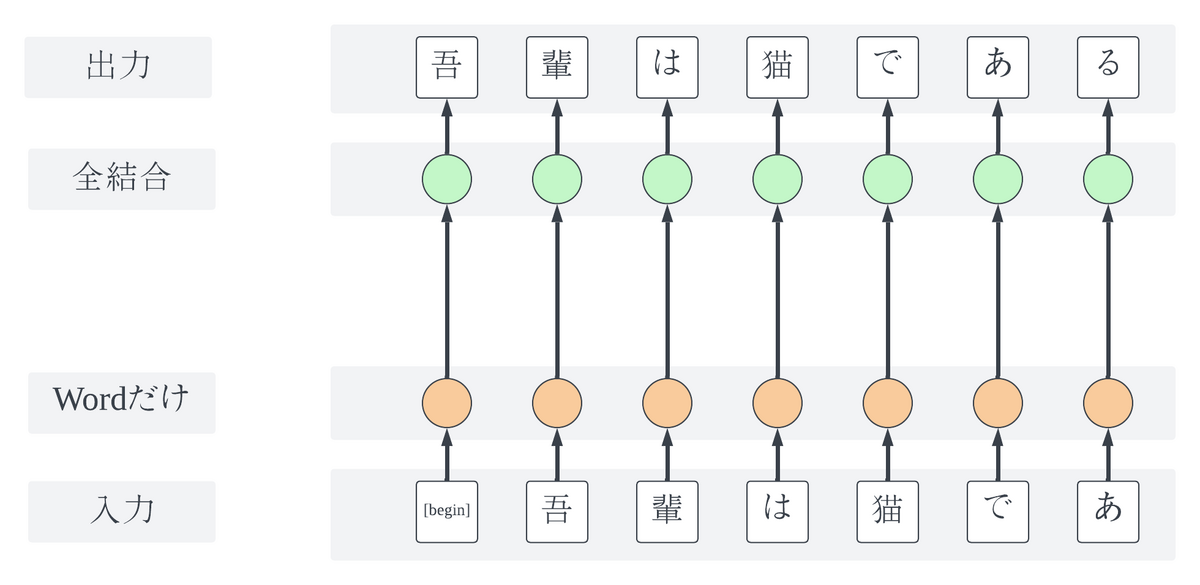
一度に GPTモデルを全て実装するのはキツイので、全体の流れや入出力の確認も兼ねて、必要最低限の部分だけを実装しようと思います。ということで、まずは下の図のような Word Embeddingと全結合層だけからなるモデルを実装します。
実装: Transformer
モデルの基礎部分が実装できたので、次に Transformerを実装していこうと思います。これは GPTモデルの論文内にある図の、水色の部分に相当します。
つまり、以下の一連のブロックを12回繰り返したものになります。
(1) Masked Multi Self Attention
(2) Layer Norm
(3) 全結合
(4) Layer Norm
一番目の Masked Multi Self Attentionというのは、 Multi-Head Self Attentionをベースにした NNブロックです。そこに GPTモデル用の変更を加え、 i文字目では i-1文字目までの情報しか使わないように抑制 (Mask)をかけています。ということで、まず初めに Multi-Head Self Attentionが何かという話なのですが、それに関する解説記事は巷に数多くあるので、申し訳ないのですが、今回はそれらを参考にしていただけるとありがたいです。個人的には、このMishaさんのツイートがとてもわかりやすいと思います。
では、次にどうやってマスクをかけるのかという話なのですが、 GPTモデルは i文字目を予測する時に i-1文字目までの情報しか使ってはいけません。そのため、 Attention機構中で i文字目以降を参照されると困ります。なので、 Attentionの計算中に、 weightの該当部分に -infをセットすることにより、 i文字目以降の情報を取ってくることを抑制 (Mask)することになります。詳細は、以下の実装例を参考にしていただけるとありがたいです。
実装: Positional Embedding / Positional Encoding
Attention機構は語順を理解できず、 Cats like dogsと Dogs like catsの見分けがつきません。なので、 Transformerを提唱した Attention is All You Needという論文では、文字位置に関する情報を入力に追加して、モデルに渡していました。私が勘違いしていない限り、 GPT用のマスキングを施した Attentionは少し事情が違い、 2層目以降の Transformerでは、文字位置を把握することも可能な気がします。ただ、性能の面からか、 GPTモデルの論文でも文字位置を入力に追加しています。
文字位置を伝える方法は色々とあり、GPTモデルの論文で採用されているのは、学習可能なバイアスを Word Embeddingに足し合わせて、トレーニングを通じて最適な方法を探す方法です。これは Positional Embeddingと呼ばれています。非常にシンプルなので、詳細については下にある実装例を確認した方が速いかもしれないです。
また、別の方法として、 Attention is All You Needの中では、位置情報を伝えるためのベクターを予め人力でデザインしておいて、 Word Embeddingに足し合わせています。これは Positional Encodingと呼ばれています。今回は GPTモデルの実装ということで詳細は省きますが、このkazemnejadさんのブログが直感的に理解しやすく、非常にわかりやすいと思いました。
実装: Byte Pair Encoding
ここまでは 1文字ずつモデルに渡して、 吾輩などの複数文字からなる単語を学習して認識してくれることを願っていました。しかし、頻出単語は単語レベルで纏めて渡してあげた方が性能が上がりそう、と言われればそんな気もします。
GPT-3の論文によると GPT-2や GPT-3では Byte Pair Encoding (BPE)というトークナイザーを使っているようです。 BPEでは、文字のマージ規則に従って文字を纏めていくことになります。例えば、マージ規則が [(吾, 輩) → 吾輩, (で, あ) → であ, (であ, る) → である]であるとします。その場合、 吾輩は猫であるという文章は
(1) 文字レベルに分解され 吾 / 輩 / は / 猫 / で / あ / るとなる。
(2) マージ規則を適用して 吾輩 / は / 猫 / であると纏められる。
(3) 各トークンは、対応する数字の IDに変換されてモデルに渡される。
という手順を辿ります。
また、辞書の作成方法もかなりシンプルで、
(1) 全ての文字を辞書に加える。
(2) 出現頻度の多い、隣接する文字のペアを規則に加えていく。
というロジックになっています。以下に説明用の簡単なコードを置いておきます。
コード (説明用なので実装しなくても大丈夫です)
- 実装例
- 実行例
以上が BPEの実装となります。上の実行例からもわかる通り、 BPEでは単語レベルではなく、 ableのようなサブワードと呼ばれる単位で区切られることになります (able自体は単語でもありますが...)。これにより、 backpropagationableのような未知語も、 back / propagation / ableのようなサブワードに分割し対応できるようになる、と言われています。
では、ここで BPEを日本語に適用したい訳ですが、日本語の文章をそのまま BPEにかけると、 [(猫, は) → 猫は, (猫, に) → 猫に, (猫, を) → 猫を]のように、助詞や助動詞とのマージが頻出するようになります。私が参考にした論文 (『日本語 Tokenizerの違いは下流タスク性能に影響を与えるか?』)では、既存の形態素解析器で単語にパースした後に、 BPEをかけているので、本記事でもそのように実装しようと思います。解析機は MeCabの Pythonラッパーを使用します。
以下の実装例では、マージ規則を生成しファイルに保存しています。トークナイズされた文章を保存することもできたのですが、後で他のデータもトークナイズする必要があるので、マージ規則を保存しています。
では、最後にトークナイザーを実装します。また、トークナイズされた文章を使ってモデルを訓練します。これで一般 GPTモデル完成となります。
Supervised Fine-Tuningモデルを訓練しよう
概要
ここでは、先ほど作成した GPTモデルを会話用にチューニングしていきます。今までは、 吾輩は猫であるのような文章を学習させていましたが、ここからは 吾輩は誰ですか?:猫のような 質問:答えもしくは クエリ:応答形式の文章を渡して、モデルを fine-tuningしていきます。このモデルを Supervised Fine-Tuning (SFT)モデルと呼びます。
この章から InstructGPTモデルの論文に書かれている内容に入るので、 InstructGPTモデルの概要についても書いておこうと思います。
GPTモデルのパラメーター数を増やして精度を良くしたからといって、ユーザーの意図した答えを返せるようになるとは言い切れません。なので、人間からのフィードバックを利用することにより、ユーザーの意図した答えを返せるようにしたい、というのが InstructGPTの考えらしいです。実際にここからは、初めに作った GPTモデルを fine-tuningしていくことにより、人間が見て良いと感じる返答を返せるように頑張ることになります。この章で訓練する SFTモデルはその第一歩となります。ちなみに、ここからは会話用にモデルをチューニングするだけなので、一般的な NLPタスクにおける性能は徐々に下がっていきます。
訓練
ということで、 SFTモデルを訓練するのですが、訓練に使用するデータを自力で用意するのは大変です。なので、こちらのMasaさんのgithubからデータをお借りして、以前訓練した GPTモデルを fine-tuningしていこうと思います。
SFTモデルを更にチューニングしよう
概要
ここからは強化学習を使い、前回作った SFTモデルを更にチューニングしていくことになります。簡単に言うと、 SFTの生成した文章を採点するモデルを使い、 SFTモデルがより得点の高い答えを生成するように訓練します。そのために、以下のような工程が必要になります。
(1) SFTモデルに質問 (例: 吾輩は誰ですか?:)を投げて、答えをサンプリングする
(2) サンプリングした答えを人間が採点する
(3) 採点された答えを使って、採点をするNNモデルを作る (Rewardモデル)
(4) Rewardモデルを使い、 SFTモデルをさらにチューニングする (InstructGPTモデル)
最後に InstructGPTモデルと書いてある通り、これが最終章となります。では、一つ目のステップから見ていこうと思います。
SFTの答えをサンプリングする
答えのサンプリングをしていきます。ここでサンプリングされた答えは、次のステップで採点されることになります。ここで言う採点とは、実際に点数を付ける訳ではなく、同一の質問に対して複数の答えをサンプリングして、それらを順位付けするという形で行われます。なので、ここでは1つの質問に対して複数の答えをサンプリングします。
サンプリングするために使用する質問は、 SFTモデルを訓練した時に使ったものを再利用しようと思います。訓練時に使ったデータを再利用するのは良くない気もしますが、実装の簡略化ということで許していただけるとありがたいです。生成された答えはファイルに書き出されます。
サンプリングした答えを採点する
次に、モデルの答えを手動で採点します。ここで言う採点とは、同一の質問に対する複数の答えを順位付けするという形で行われます。なので、前のステップでファイルに出力した答えを、望ましい順に上から下に並べ替えることになります。
コード
- 採点例
Rewardモデルを訓練する
では、 SFTモデルの生成した答えを採点するモデル (Rewardモデル)を作っていこうと思います。 Rewardモデルは、アーキテクチャ的にはほぼ SFTモデルと同じです。唯一の違いは、最終層がスカラーを出力するということだけです。なので、 SFTモデルの最終層を取り替えた後に fine-tuningすることになります (実装の簡略化のため、今回の実装例では最終層を取り除かず追加だけしています) 。
ということで、 Rewardモデルを訓練するために以下の手順を繰り返します。
(1) 1つの質問と、それに対応する順位付けされた答え達を取ってくる。
(2) Rewardモデルでそれぞれの答えを採点する。
(3) 採点された答えを 2つ取ってきて、 を計算する (ここで
番目の答えは
番目の答えよりも手動採点の順位が高いものとします)。
(4) 3の値を全ての答えのペアに対して計算し、その平均を損失としてモデルを訓練する。
では、以下のコードでモデルを訓練していこうと思います。
InstructGPTモデルを訓練する。
では、最後に強化学習 (RL)を使って InstructGPTモデルを訓練します。 InstructGPTモデルは、 SFTモデルを以下の目的関数に対して fine-tuningすることにより作成されます (論文)。
- : 質問
- : 答え
- : 質問
と答え
に対して、 Rewardモデルの出力する点数
- : InstructGPTモデルが質問
に対して、答え
を生成する確率
- : SFTモデルが質問
に対して、答え
を生成する確率
- : 重み付けのハイパーパラメーター
- : 重み付けのハイパーパラメーター
- [f(x)]:
を一般 GPTモデル訓練用のデータから取ってきた時のf(x)の平均値
] についてですが、これは Proximal Policy Optimization (PPO)というテクニックから来ています。軽く説明をすると、本来であれば 1項目の Rewardモデルの項だけで訓練したいです。ただ、それだけだとモデルのパラメーターが急激に変化しすぎてしまい、訓練が不安定になるかもしれません。なので、 2項目の
という KL-divergenceを加えることで、元の SFTモデルから距離が離れすぎないようにしています。また、実装例にも含まれていますが、目的関数だけではなく、トレーニングの方でも Clipped Surrogate Objectiveと呼ばれる手法が使われています。申し訳ないのですが、 PPOについての詳しい説明は、元論文やめんだこさんのブログなどを参照してくださると助かります。
最終項についてですが、これは通常の GPTモデル用の目的関数となっています。 InstructGPTモデルは元の GPTモデルに比べ、一般的な NLPタスクに対しての性能が悪くなってしまいます。なので、ある程度の汎化性能を残そうということらしいです。今回は実装の簡略化のため、 を採用して、論文中でいうところの PPOモデルを実装しようと思います。 InstructGPTと呼ばれるモデルは
を採用しています。
ということで、以下が最後の実装となります。
コード
- 実装例 (こちらの実装も参考になると思います)
- 実行例
最後に
InstructGPTの実装、お疲れ様でした。ここまでお付き合いいただき、ありがとうございました。
コドゲのコンペ前日チェックリスト
CodinGameの大きなコンペが半年に一度しかなく記憶を失いがちなので、コンペに必要な知識をここに残しておきます。
モンテカルロ木 、Mini-Max木
まずはこの記事を読む。
2人同時にプレイするゲームではDUCTを使う。
AlphaZeroを使えるならAlphaZero一択。AlphaZeroの元論文はいくつかのバージョンが存在するがこれが一番詳細なはず。17ページ目のSearchセクションに必要なことが全て書いてある。
ランダム性のあるゲームには Information Set MCTSを使う。ネットで探しても資料はあまり見つからない。とりあえず似たようなノードがあれば1つに纏めて上手く行くことを願う。
焼き鈍し、ビームサーチ、何らかの探索
使える時は絶対に使う。綺麗に使えない時も使ったほうがいい。使ってる解法と使ってない解法だと使ってる方が確実に強い。無理だと思っても無理やり使ったほうがいい。
手元でシミュレーターを走らせる
以下の記事にしたがって手元でシミュレーターを走らせておく。mvn等のインストールが必須なので実際に走らせておくこと。コード構成などのマイナー変更で記事通りに走らせられなくなる可能性もあるので、動く原理も理解しておいたほうがいい。コンペ中に動かなかった場合はDiscordのコンペ用チャンネルで聞くと答えてくれる。
Discord
CodinGameのこのページにDiscordへのリンクが貼ってある。コンペ用のチャンネルがあるので何かあった時はそこに書くといい。コドゲのフォーラムよりも活発な感じがする。
コドゲのシミュレーターを手元で走らせる方法 2023
本記事は、中身をある程度理解した上でSpring Challenge 2023のシミュレーターをローカルで走らせようというものになっています。賢く手軽に走らせたいという方はボンドさんの記事などを参考にした方がいいかもしれないです。
本記事では、初めにビジュアライザ上で自分のボットを走らせた後に、ビジュアライザを起動せずに連続で試合を回せるようにしていきます。
http://localhost:8888/に何かを表示させる
ビジュアライザを完璧に走らせるには複数のステップを踏む必要がある。まずはバグった状態のローカルサーバーを建て、そこから目で確認できる形でバグを1つずつ直していく。
ローカルサーバーを建てるエントリポイントがsrc/test/java/Spring2023Main.javaにある。src/testの下にあるファイルはコンパイル後のjarに含まれないので、以下のコマンドでsrc/mainに移動する。
mv src/test/java/Spring2023Main.java src/main/java/
以下のコマンドでコンパイル。
mvn assembly:assembly -DdescriptorId=jar-with-dependencies
target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jarが生成される。以下のコマンドでローカルサーバー起動。
java -cp target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jar Spring2023Main
http://localhost:8888/にアクセスできるようになっている。
壊れているので紺色のページが表示される。
TypeScriptでJavaScriptを生成する
先程の紺色のページのエラーメッセージを見てみるとViewModule.jsをロードできなかったと書いてある。CodinGameは最近TypeScriptを使うようになったらしくTypeScriptからJavaScriptを生成する必要があるらしい。しかし、ド素人なのでよくわかってはいない。
${root}/typescriptというディレクトリがあるがこれは関係がない。実際には${root}/src/main/resources/view/ts内のファイルをトランスパイルする必要があり、以下のコマンドでどうにかなる。最後のyarn startはtscをwatchモードで起動し待機状態に入るので、適宜自分で終了する必要がある。
cd src/main/resources/view/
yarn install
yarn start
これでsrc/main/resources/view/graphcis内にJavaScriptが生成された。余談だが、npm ci; npm run startを走らせろというコメントをよく見るが、CodinGameの社内レポジトリを参照しようとするらしく動かない。yarn install; yarn startだと動く。理由は不明。
何はともあれJavaScriptが生成されたので再びローカルサーバーを建ててみる。
mvn clean assembly:assembly -DdescriptorId=jar-with-dependencies
java -cp target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jar Spring2023Main
http://localhost:8888/にアクセスすると多少直ったページが表示される。
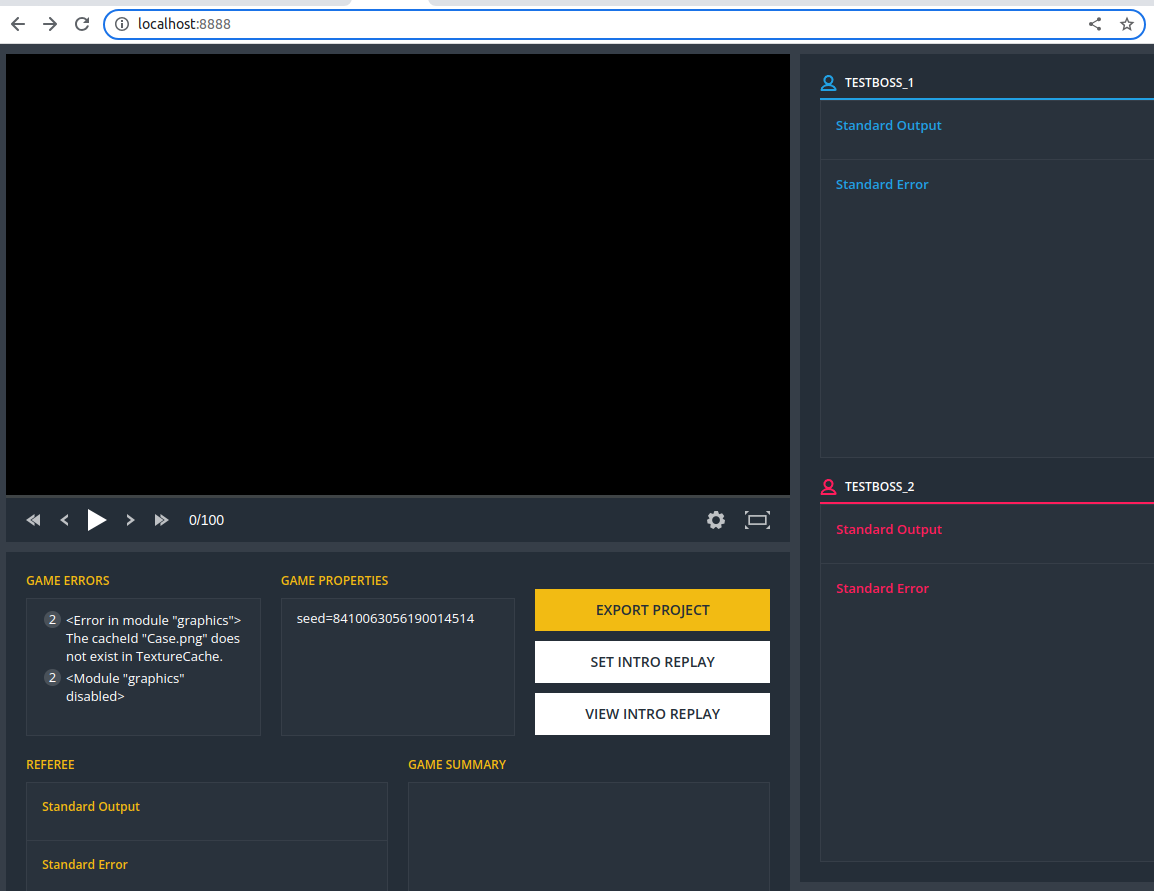
画像を正しい場所に置く
先程のページのエラーメッセージを見てみると/assets/assets/spritesheet.pngにアクセスできないと言っている。ただ、/assets/spritesheet.pngにはアクセスできる。つまり何故かURL内でassetsがダブる仕様になっている。このspritesheet.pngはsrc/main/resources/view/assetsディレクトリから来ており、そのディレクトリ内の全てのファイルに同様の仕様が適用される。なのでassets内のファイルだけをassets/assetsに移動するようにMavenにお願いする。
assembly.xmlをルートディレクトリ下に作成し、以下の内容をコピペする。
<assembly xmlns="http://maven.apache.org/ASSEMBLY/2.1.0"
  xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
  xsi:schemaLocation="http://maven.apache.org/ASSEMBLY/2.1.0 http://maven.apache.org/xsd/assembly-2.1.0.xsd">
  <id>jar-with-dependencies</id>
  <formats>
    <format>jar</format>
  </formats>
  <includeBaseDirectory>false</includeBaseDirectory>
  <dependencySets>
    <dependencySet>
      <outputDirectory>/</outputDirectory>
      <useProjectArtifact>true</useProjectArtifact>
      <unpack>true</unpack>
      <scope>runtime</scope>
    </dependencySet>
  </dependencySets>
  <fileSets>
    <fileSet>
      <directory>${project.basedir}/src/main/resources/view/assets</directory>
      <useDefaultExcludes>true</useDefaultExcludes>
      <outputDirectory>/view/assets/assets</outputDirectory>
    </fileSet>
    <fileSet>
      <directory>${project.basedir}/src/main/resources/view</directory>
      <useDefaultExcludes>true</useDefaultExcludes>
      <outputDirectory>/</outputDirectory>
      <excludes>
        <exclude>view/assets/**</exclude>
      </excludes>
    </fileSet>
  </fileSets>
</assembly>
assembly.xmlを指定してMavenでコンパイルする。
mvn clean assembly:assembly -Ddescriptor=assembly.xml
以下のコマンドでローカルサーバー起動。
java -cp target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jar Spring2023Main
http://localhost:8888/にアクセス。これで問題なく動くはず。ゲーム画面が動いていない用に見えるが、これはデフォルトのボットが何もしないため。ビジュアライザのセットアップはおしまい。
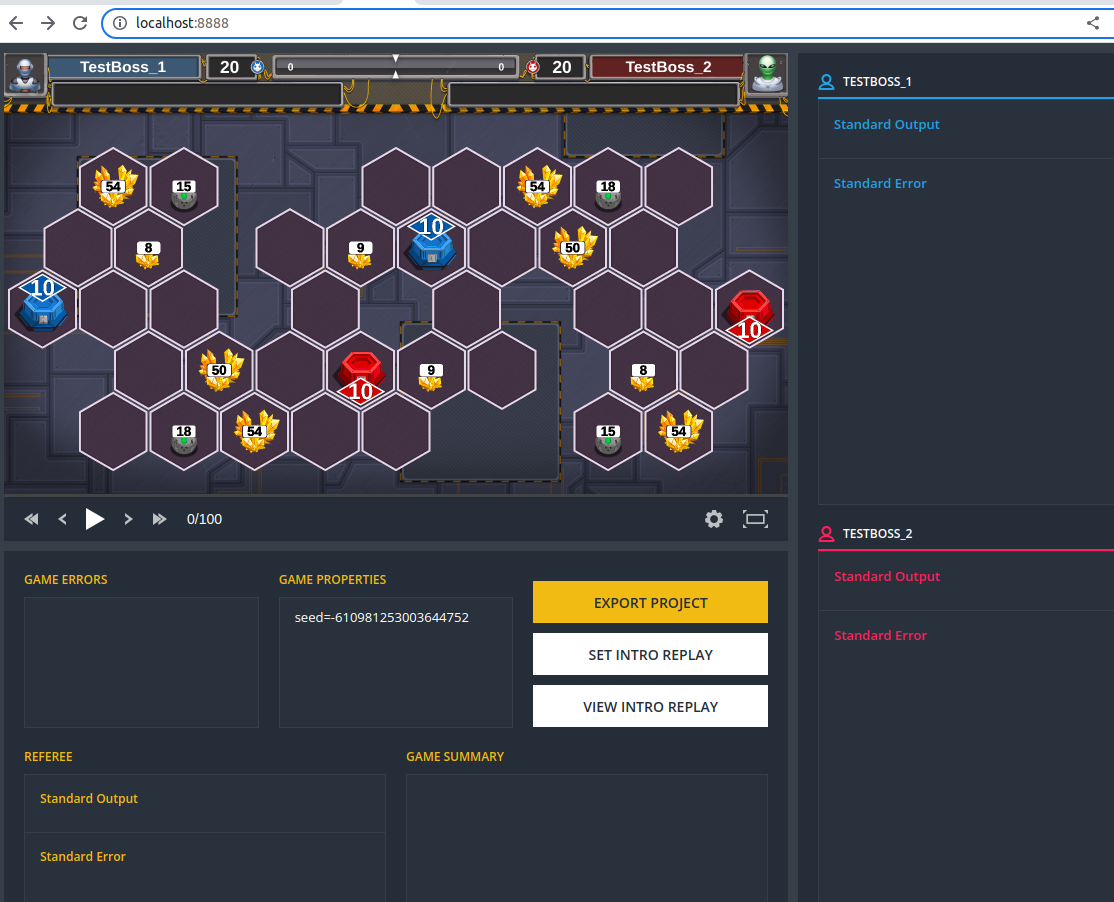
自分のボットを戦わせる
初めに移動したローカルサーバーを起動するためのMainクラスsrc/main/java/Spring2023Main.javaの中でgameRunner.addAgentが呼ばれているが、この引数としてボットの実行コマンドが渡されている。なので、そこを自分のボットを起動するコマンドに書き換えればいい。
-        gameRunner.addAgent("python3 config/Boss.py", "TestBoss_1");
-        gameRunner.addAgent("python3 config/Boss.py", "TestBoss_2");
+        gameRunner.addAgent("/home/nanaeda/main");
+        gameRunner.addAgent("/home/nanaeda/main");
Spring Challenge 2023はリーグによって入力形式が変わるため、src/main/java/Spring2023Main.java内のgameRunner.setLeagueLevelの引数を適切な値に変更しないと入力を受け取る所で止まったりする。どのリーグレベルの数値がWoodやGoldに対応するかはよくわからないので、コード中でリーグレベルの値が使用されている所を確認するとよい。
-        gameRunner.setLeagueLevel(3);
+        gameRunner.setLeagueLevel(4);
src/main/java/com/codingame/game/Referee.java内でのリーグレベルの使用方法を確認した結果、レベル4以上から入力にスコアが追加されるらしい。
            int leagueLevel = gameManager.getLeagueLevel();

            if (leagueLevel == 1) {
                Config.FORCE_SINGLE_HILL = true;
                Config.ENABLE_EGGS = false;
                Config.LOSING_ANTS_CANT_CARRY = false;
                Config.MAP_RING_COUNT_MAX = 4;
            } else if (leagueLevel == 2) {
                Config.FORCE_SINGLE_HILL = true;
                Config.LOSING_ANTS_CANT_CARRY = false;
                Config.MAP_RING_COUNT_MAX = 5;
            }
            // level 3 = interactions, big map, multiple hills
            if (leagueLevel >= 4) {
                Config.SCORES_IN_IO = true;
            }
いつも通りコンパイルしてサーバーを起動する。
mvn clean assembly:assembly -Ddescriptor=assembly.xml
java -cp target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jar Spring2023Main
http://localhost:8888/にアクセスすると動いているはず。
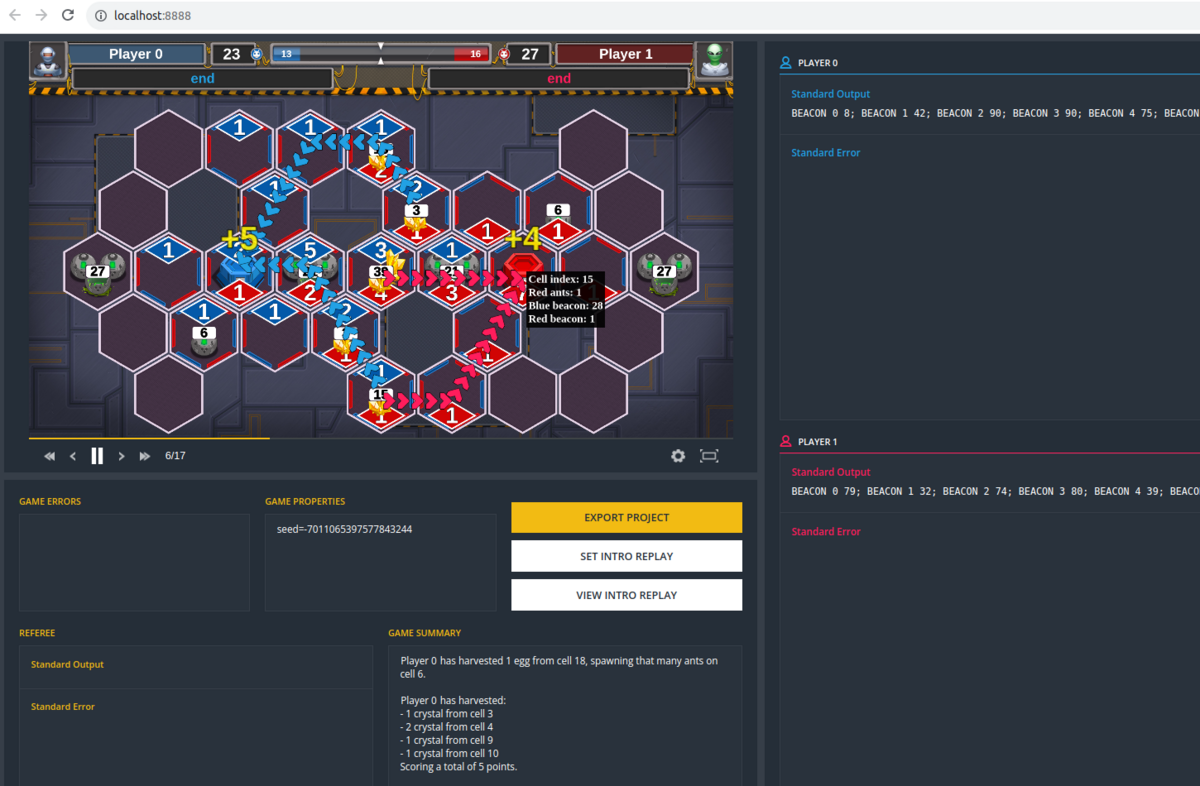
連続で試合を回す
今まではMainクラス内でMultiplayerGameRunner::startを呼び、ビジュアライザを起動していた。これをMultiplayerGameRunner::simulateに変更するとビジュアライザを起動せずに対戦だけを行うことができる。例えば、以下のようなコード変更をsrc/test/java/Spring2023Main.javaに行うことができる。
 import com.codingame.gameengine.runner.MultiplayerGameRunner;
+import com.codingame.gameengine.runner.simulate.GameResult;
 import com.google.common.io.Files;
         gameRunner.setLeagueLevel(4);

-        gameRunner.start();
+        final GameResult result = gameRunner.simulate();
+        System.out.println("Player0 score=" + result.scores.get(0));
+        System.out.println("Player1 score=" + result.scores.get(1));
     }
コンパイルと起動方法は前回と同じ。
mvn assembly:assembly -Ddescriptor=assembly.xml
java -cp target/spring-2023-ants-1.0-SNAPSHOT-jar-with-dependencies.jar Spring2023Main
アウトプット例は以下の通り。
Player0 score=66
Player1 score=80
これで対戦だけを回すことができるのだが、CodinGameのコードはJava起動時に初期化されたグローバル変数をそのまま使っている可能性が高い。つまり、forループで対戦を回すとバグるかもしれない。なので対戦毎にJavaを起動すると安全。
コドゲのシミュレーターを手元で走らせる方法 2022
こっちに最新バージョンがあるぞ!


